如果把AI训练芯片的选型比作配一台工作站,那么架构决定你能跑什么活,制程决定你能塞进多少晶体管,显存决定你能喂多大的模型,能效则决定长期运行的成本。看个球在产品与方案栏目里持续整理公开参数,本篇按并排对比的思路,盘点五类常见训练芯片方案的设计取舍,帮助你建立自己的判断框架。
一、五类方案并排看:架构决定了算力组织方式
结论先说:训练芯片的性能上限,往往在架构阶段就已经被框定,后端的制程和封装只是把这个上限兑现出来。看个球在整理公开资料时发现,不同方案在矩阵运算单元的组织密度、片上缓存层级、互连拓扑上的差异,直接影响了它们适合的模型规模。
- 通用GPU路线:以大量并行计算单元加高带宽显存为核心,生态成熟,适合从训练到推理的通用场景,代价是单卡功耗偏高。
- 专用训练加速器:把矩阵乘加单元做深做宽,片上缓存占比更高,单位面积算力密度突出,但对算子覆盖范围要求较高。
- 存算一体探索方案:把计算单元贴近存储阵列,减少数据搬运开销,能效表现亮眼,适合访存密集型的推理与部分训练负载。
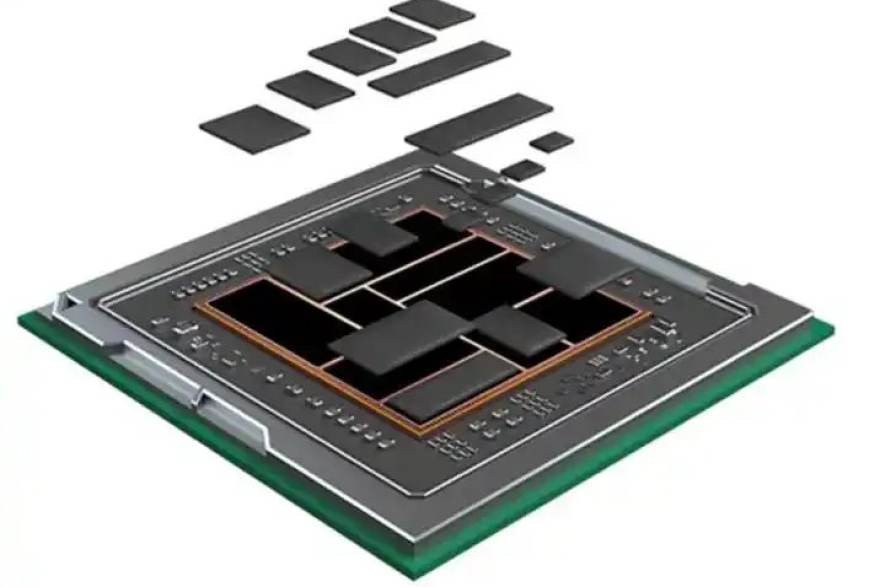
- Chiplet组合方案:把计算芯粒与I/O芯粒分开制造再封装,灵活度高,良率与成本结构更可控,是近两年公开讨论较多的方向。
- 光互连集群方案:在芯片间互连上做文章,缓解大规模集群的通信瓶颈,适合超大规模训练任务。
看个球的对比视图会把这几类方案的架构参数放在同一张表里,读者可以直观看到算力单元数量、缓存容量与互连带宽的差异,而不是被单一跑分数字带偏。
二、制程节点:不是越先进越合适
制程是很多人选型时最先看的指标,但它更像是一个约束条件,而不是目标本身。看个球梳理公开规格书后发现,训练芯片普遍集中在较先进的制程节点上,原因是单位面积需要容纳大量计算单元;但制程越先进,流片成本与设计复杂度也同步上升。
对于中小规模的训练需求,采用相对成熟制程配合更大封装面积的方案,反而可能在总拥有成本上更划算。看个球建议读者在对比时把制程和芯片面积、封装形式放在一起看:同样算力下,面积更小意味着每片晶圆能切出更多芯片,这层关系比单纯比较纳米数字更有意义。
三、显存与能效:训练场景的两条硬约束
显存容量和显存带宽决定了单卡能承载的模型规模与数据吞吐,而能效比决定了集群规模上去之后的电费与散热压力。看个球在方案对比中把这两项单独列出,是因为它们常常被算力数字掩盖。
- 显存容量:决定参数与激活值能否常驻,容量不足时需要频繁换入换出,实际训练效率会明显下降。
- 显存带宽:决定数据供给速度,带宽不足时计算单元会出现等待,算力利用率打折。
- 能效比:通常以每瓦算力衡量,公开参数里常见的是整卡功耗与峰值算力的比值,看个球提醒读者注意测试条件是否一致。
- 互连能效:大规模集群里,芯片间通信的功耗占比不容忽视,互连方案的选择会改变整体能效曲线。
这四项参数之间并非独立,显存带宽提升往往伴随功耗上升,能效优化又可能牺牲峰值算力。看个球的并排视图价值就在这里:把取舍关系摆出来,让读者自己判断哪一头更重要。
四、怎么用对比视图做选型判断
看个球建议按三步走:先按模型规模筛显存容量,再按训练时长与电费预算筛能效,最后按生态成熟度筛架构。三步之后剩下的方案通常不多,再细看制程与封装细节即可。
需要说明的是,公开参数只能反映设计意图,实际表现还受软件栈、编译器优化和集群调度影响。看个球的产品与方案栏目会持续补充公开规格与架构说明,并在安卓、苹果iOS、Windows电脑版和Mac电脑版客户端同步更新,方便读者随时并排查看。看懂取舍,比记住排名更有用。
网友评论 热议
说说你的看法