训练方案
AI推理芯片选型前瞻:显存带宽与能效的取舍逻辑
从架构、制程、显存与能效四个维度并排看AI推理芯片,梳理带宽受限与算力闲置的常见错配,帮读者理解不同方案在训练与推理场景下的设计取舍。
- 架构
- 矩阵计算阵列
- 制程
- 7nm
- 显存
- 48 GB HBM2e
- 能效
- 300 W 级
看个球产品与方案栏目提供多款 AI 训练与推理芯片的并排对比视图,按架构、制程、显存与能效维度整理公开参数,帮助读者理解不同方案的设计取舍与适用场景。
把公开参数放到同一张表里看,架构路线、制程节点、显存配置与能效表现的差异会更直观
| 对比项 | 训练型方案 A | 训练型方案 B | 推理型方案 C | 推理型方案 D |
|---|---|---|---|---|
| 核心架构 | 通用矩阵计算阵列,支持多卡互联 | 张量核心 + 高带宽缓存分层 | 稀疏计算单元,面向低延迟推理 | 多核并行架构,支持批量并发 |
| 制程工艺 | 7nm | 5nm | 12nm | 7nm |
| 显存类型 | HBM2e 高带宽显存 | HBM3 高带宽显存 | LPDDR5 低功耗显存 | GDDR6 显存 |
| 显存容量 | 48 GB | 80 GB | 16 GB | 24 GB |
| 显存带宽 | 约 1.2 TB/s | 约 2.4 TB/s | 约 0.3 TB/s | 约 0.8 TB/s |
| 典型功耗 | 300 W 级 | 400 W 级 | 75 W 级 | 150 W 级 |
| 能效取向 | 算力优先,需配套液冷或强风冷 | 算力与带宽均衡,适合集群部署 | 功耗优先,可做无风扇边缘部署 | 性价比优先,适合中小规模推理 |
| 互联方式 | 多卡高速互联,支持分布式训练 | 高速互联 + 片间缓存共享 | PCIe 直连,单机多卡即可 | PCIe 直连,支持多实例切分 |
| 典型场景 | 大模型预训练、批量微调 | 大规模训练集群、长序列任务 | 边缘推理、实时特征计算 | 在线推理、批量离线打分 |
| 部署形态 | 机房集群 | 机房集群 | 边缘设备 | 机架服务器 |
按训练与推理两条主线拆分,先看定位,再回到参数表逐项核对
从架构、制程、显存与能效四个维度并排看AI推理芯片,梳理带宽受限与算力闲置的常见错配,帮读者理解不同方案在训练与推理场景下的设计取舍。
RISC-V在端侧AI的落地进展如何?本文从架构扩展、能效表现与软件生态三个维度盘点公开方案,梳理开源指令集在端侧推理场景的真实取舍。
Chiplet正在改变芯片的设计与成本结构。本文盘点五条主流先进封装技术路线的公开参数,从互连密度、良率逻辑与能效维度梳理各自适用场景。
集群规模上去之后,芯片间互连成了性能瓶颈。本文盘点四条主流互连技术路线的公开参数,从带宽、延迟与能效维度梳理大规模AI集群的设计取舍。
推理芯片的算力数字很好看,实际吞吐却常被显存带宽卡住。本文从公开参数出发,盘点显存带宽对推理性能的影响路径与方案取舍。
物联网设备的能效账,待机功耗往往比峰值性能更重要。本文盘点四条低功耗芯片方案路线,从待机功耗、集成度与制程维度梳理公开参数与设计取舍。
参数不是越大越好,先弄清每个维度在方案里承担什么角色
通用阵列偏向灵活,专用张量单元偏向吞吐。架构决定了一个方案更容易适配哪类模型与算子。
更先进的节点通常带来更高能效密度,但也意味着更高的封装与散热要求,需与机房条件一起考虑。
容量决定能装下多大的模型与批次,带宽决定数据搬运是否成为瓶颈,两者要放在一起评估。
单卡功耗乘以部署规模才是真实成本,边缘场景往往更看重每瓦性能而不是峰值算力。
同样的参数,放在不同业务里侧重点完全不同
需要大容量高带宽显存与多卡互联能力,方案 B 的带宽与互联设计更适合长时间训练任务。
关注首包延迟与并发成本,方案 D 的多实例切分能力可以让同一张卡承载更多服务实例。
功耗与体积是硬约束,方案 C 的低功耗显存与紧凑封装更适合机柜之外的部署环境。
吞吐优先、延迟不敏感,方案 A 的通用阵列在算子兼容性上更省心,调度也更简单。
围绕架构取舍与参数对比的深度内容,按阅读热度排列
从参数表走进设计取舍,逐篇拆解不同方案的思路
从产业链视角看芯片制造,设备与材料是关键支撑。本文盘点五类核心环节的公开技术进展,梳理制程节点演进对设备与材料方案提出的新要求。
每瓦算力是AI芯片对比的常用指标,但榜单数字受多个变量影响。本文从测试负载、精度设置、封装形式与系统口径四个维度解读能效比参数。
车规芯片选型不只是看算力。本文按功能安全等级、制程与能效维度盘点智能座舱与驾驶辅助的公开方案,梳理安全冗余与性能之间的设计取舍。
电源管理芯片是能效链条的起点。本文盘点四条主流电源管理方案路线,从转换效率、集成度与制程维度梳理公开参数,梳理不同负载场景的设计取舍。
显存带宽正在成为AI芯片的性能瓶颈。本文盘点四条主流显存方案路线,从带宽、能效与封装复杂度维度梳理公开参数,帮助读者理解设计取舍。
推理芯片的能效表现直接决定部署成本。本文按端侧与数据中心两类场景盘点能效维度的公开参数,梳理显存、制程与架构对能效的影响路径。
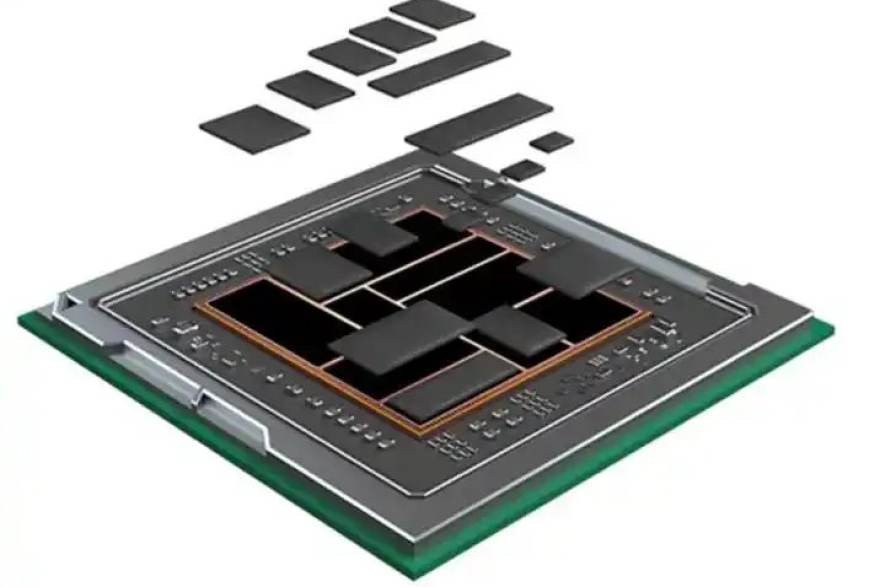
从架构、制程、显存与能效四个维度并排梳理五类主流AI训练芯片方案,帮你看清高算力密度与低功耗之间的设计取舍,选型不再盲目。
训练集群的性能不只看单卡。本文盘点从单卡到机架的四种扩展设计,从互连拓扑、功耗密度与散热维度梳理公开参数,理解规模扩展的取舍。
多端同步查看方案对比与数据面板,随时切换设备继续阅读